Un service reçoit les mesures de capteurs, un autre doit les traiter et les stocker. Si le premier appelle le second en REST, les deux sont liés : quand le second est arrêté ou lent, le premier ne peut plus rien livrer. Kafka se place entre les deux : le premier publie un message, le second le lit à son rythme.
Cet article monte ce lien de bout en bout, en local : Kafka en mode
KRaft dans Docker, un service Spring Boot qui publie une simple ligne de
texte, un autre qui la lit, et une page qui affiche la partition et
l’offset de chaque message. Tout le code est dans le tag
phase-1
du dépôt public iot-monitoring-platform.
Le projet en un schéma
- iot-backend-ingestion (port 8081) reçoit une ligne de texte, par
exemple
sensor-1 TEMPERATURE 21.5, et la publie dans le topiciot-sensor-events. - iot-backend-processing (port 8082) lit le topic, stocke chaque message dans PostgreSQL et le rend via une API REST.
- Un simulateur envoie une ligne par seconde, et une page Angular affiche les derniers messages.
Le message est un simple String, sans clé, sur un topic d’une seule
partition. C’est volontaire : le but est de voir le chemin complet
d’un message, avec le moins de réglages possible. Cet article ne parle
que de la partie Kafka ; la règle métier et l’organisation du code
(architecture hexagonale) feront l’objet d’un autre article.
À la fin, vous aurez Kafka et PostgreSQL dans Docker, les deux services sur votre machine, et des messages dont vous suivez la partition et l’offset, de l’envoi jusqu’à la base.
Kafka en mode KRaft avec l’image officielle
Depuis Kafka 4.0, Kafka fonctionne entièrement sans ZooKeeper : en mode KRaft, ce sont des nœuds contrôleurs de Kafka qui gèrent les métadonnées du cluster. Pour un poste de développement, un seul nœud peut être à la fois broker et contrôleur : il suffit donc d’un seul conteneur.
Le projet utilise l’image officielle du projet Apache Kafka,
apache/kafka. Avec sa configuration par défaut, elle démarre un seul
nœud, qui est à la fois broker et contrôleur, et écoute sur le port
9092. Le fichier compose.yaml du projet (extrait) :
services:
  kafka:
    # Official Apache Kafka image. With its default config it starts one
    # node in KRaft mode (no ZooKeeper) and listens on localhost:9092.
    image: apache/kafka:4.4.0
    container_name: iot-kafka
    ports:
      - "9092:9092"
Aucune variable d’environnement : pas de KAFKA_ZOOKEEPER_CONNECT, pas
de liste de listeners à écrire. Le même fichier démarre aussi
PostgreSQL.
docker compose up -d
Les logs du conteneur montrent ce que fait la configuration par défaut
(docker logs iot-kafka, extrait) :
	advertised.listeners = [PLAINTEXT://localhost:9092]
	node.id = 1
	process.roles = [broker, controller]
process.roles = [broker, controller] : un seul nœud joue les deux
rôles. advertised.listeners est l’adresse que Kafka donne aux
clients : localhost:9092. Les services Spring Boot tournent sur la
machine, cette adresse leur convient telle quelle.
Publier un String
La configuration
Le fichier application.yml du service d’ingestion :
spring:
  application:
    name: iot-backend-ingestion
  kafka:
    # Spring Boot uses String serializers by default: the message is a plain String.
    bootstrap-servers: localhost:9092

iot:
  kafka:
    topic: iot-sensor-events
Il n’y a pas de classe de configuration Kafka dans le projet. Spring Boot
crée un KafkaTemplate, et ses sérialiseurs par défaut sont
StringSerializer, pour la clé comme pour la valeur. Pour publier du
texte, il n’y a donc rien à régler. bootstrap-servers vaut déjà
localhost:9092 par défaut ; je l’écris quand même, pour qu’on voie
où le service se connecte.
L’envoi
L’adaptateur qui publie (extrait de KafkaSensorMessagePublisher) :
@Override
public void publish(SensorMessage message) {
    // No key: in phase 1 the topic has one partition, so the order is
    // kept anyway. The key comes in phase 2, with several partitions.
    kafkaTemplate.send(topic, message.text())
            .whenComplete((result, exception) -> {
                // The send is asynchronous: an error only shows in the log.
                // Error handling (retry, DLT) comes in phase 2.
                if (exception != null) {
                    LOGGER.error("Could not publish the message '{}' to {}", message.text(), topic, exception);
                } else {
                    LOGGER.info("Published '{}' to {} (partition {}, offset {})", message.text(), topic,
                            result.getRecordMetadata().partition(), result.getRecordMetadata().offset());
                }
            });
}
send ne bloque pas : il renvoie un CompletableFuture<SendResult>.
Le résultat arrive plus tard, avec la partition et l’offset que Kafka a
donnés au message. C’est pour cela que le contrôleur REST répond
202 Accepted et non 200 OK : le service a confié le message à Kafka,
mais il n’attend pas la confirmation. La limite est claire : si l’envoi
échoue, l’erreur n’apparaît que dans le log. La gestion des erreurs
viendra avec la phase 2.
Le topic
Le topic est déclaré par un bean NewTopic (extrait de
IngestionConfig) :
@Bean
public NewTopic sensorEventsTopic(IotKafkaProperties properties) {
    return TopicBuilder.name(properties.topic())
            .partitions(1)
            .replicas(1)
            .build();
}
Au démarrage, Spring crée le topic s’il n’existe pas ; s’il existe déjà, le bean est ignoré. Le service ne dépend donc pas de la création automatique des topics par le broker. Une partition et une réplique : assez pour un seul broker local.
docker exec iot-kafka /opt/kafka/bin/kafka-topics.sh --bootstrap-server localhost:9092 --describe --topic iot-sensor-events
Topic: iot-sensor-events	TopicId: oiLmbWoqSneUtet0x7hxCw	PartitionCount: 1	ReplicationFactor: 1	Configs: min.insync.replicas=1,segment.bytes=1073741824
	Topic: iot-sensor-events	Partition: 0	Leader: 1	Replicas: 1	Isr: 1	Elr: 	LastKnownElr:
Consommer
Le listener
Côté processing, la configuration ajoute un groupe de consommateurs :
spring:
  kafka:
    # Spring Boot uses String deserializers by default: the message is a plain String.
    bootstrap-servers: localhost:9092
    consumer:
      group-id: iot-backend-processing
      # Read the topic from the start when the group has no offset yet,
      # so messages sent before the first start are not lost.
      auto-offset-reset: earliest
Et le listener (extrait de SensorMessageListener) :
@KafkaListener(topics = "${iot.kafka.topic}")
@Transactional
public void onMessage(ConsumerRecord<String, String> consumerRecord) {
    ReceivedMessage stored = storeMessage.store(
            consumerRecord.value(), consumerRecord.partition(), consumerRecord.offset());
    // … log of the result
}
Le ConsumerRecord donne la valeur (notre texte), mais aussi sa place
dans le topic : la partition et l’offset. Le service les stocke avec le
message, pour qu’on puisse les voir sur la page.
Le groupe iot-backend-processing est le nom sous lequel Kafka retient
où le consommateur en est : pour chaque partition, une position
« commitée », l’offset du prochain message à lire. Au redémarrage, le
service reprend à cette position.
Le piège de auto-offset-reset
Que fait un consommateur quand son groupe n’a encore aucune position
enregistrée, par exemple au tout premier démarrage ? C’est le rôle de
auto.offset.reset. Ses valeurs principales :
| Valeur | Sans position enregistrée, le consommateur… |
|---|---|
latest (par défaut) | commence à la fin du topic : il ne lit que les messages qui arrivent après |
earliest | commence au début du topic : il lit aussi les messages déjà présents |
none | s’arrête avec une erreur |
Le réglage ne joue que dans ce cas. Dès que le groupe a une position, le consommateur reprend là où il en était.
Pour le voir, deux nouveaux groupes lisent le même topic, qui contient déjà deux messages. D’abord avec la valeur par défaut :
docker exec iot-kafka /opt/kafka/bin/kafka-console-consumer.sh --bootstrap-server localhost:9092 --topic iot-sensor-events --group demo-latest --timeout-ms 5000
[2026-10-24 16:59:56,249] ERROR Error processing message, terminating consumer process:  (org.apache.kafka.tools.consumer.ConsoleConsumer)
org.apache.kafka.common.errors.TimeoutException
Processed a total of 0 messages
Puis avec earliest :
docker exec iot-kafka /opt/kafka/bin/kafka-console-consumer.sh --bootstrap-server localhost:9092 --topic iot-sensor-events --group demo-from-start --command-property auto.offset.reset=earliest --timeout-ms 5000
sensor-1 TEMPERATURE 21.5
sensor-3 HUMIDITY 47.2
[2026-10-24 17:01:09,610] ERROR Error processing message, terminating consumer process:  (org.apache.kafka.tools.consumer.ConsoleConsumer)
org.apache.kafka.common.errors.TimeoutException
Processed a total of 2 messages
Le TimeoutException est normal : --timeout-ms 5000 arrête l’outil
après cinq secondes sans nouveau message. (J’ai retiré de ces sorties
une ligne d’information sur le protocole KIP-848.)
Avec latest, le premier groupe n’a rien lu : les deux messages étaient
là avant lui. C’est exactement ce qui arriverait au service de
processing s’il démarrait après l’ingestion avec la valeur par défaut.
D’où auto-offset-reset: earliest dans son application.yml.
Lancer le projet et voir Kafka travailler
Kafka et PostgreSQL tournent déjà (docker compose up -d). Dans deux
terminaux, à la racine du projet :
cd iot-backend-processing
mvn spring-boot:run
cd iot-backend-ingestion
mvn spring-boot:run
Puis un message :
curl -i -X POST -H "Content-Type: text/plain" --data "sensor-1 TEMPERATURE 21.5" http://localhost:8081/api/messages
HTTP/1.1 202
Content-Length: 0
Date: Sat, 24 Oct 2026 16:59:19 GMT
Les deux services racontent le trajet du message dans leurs logs (après un deuxième message ; je ne garde que la fin des lignes, sans la date ni le nom du thread) :
Published 'sensor-1 TEMPERATURE 21.5' to iot-sensor-events (partition 0, offset 0)
Published 'sensor-3 HUMIDITY 47.2' to iot-sensor-events (partition 0, offset 1)
Stored 'sensor-1 TEMPERATURE 21.5' (partition 0, offset 0)
Stored 'sensor-3 HUMIDITY 47.2' (partition 0, offset 1)
Le producteur et le consommateur voient la même position : partition 0, offsets 0 puis 1. Sur une partition, l’offset est simplement le rang du message, et il ne fait que grandir.
L’outil kafka-consumer-groups.sh montre où en est le groupe du service
de processing (sortie raccourcie : sans les colonnes CONSUMER-ID,
HOST et CLIENT-ID) :
docker exec iot-kafka /opt/kafka/bin/kafka-consumer-groups.sh --bootstrap-server localhost:9092 --describe --group iot-backend-processing
GROUP                  TOPIC             PARTITION  CURRENT-OFFSET  LOG-END-OFFSET  LAG
iot-backend-processing iot-sensor-events 0          2               2               0
CURRENT-OFFSET est la position commitée du groupe (le prochain message
à lire), LOG-END-OFFSET la fin de la partition, et LAG l’écart entre
les deux : 0, le service est à jour.
Pour envoyer un flux continu, le projet a un simulateur (une ligne par seconde) :
cd iot-event-simulator
mvn compile exec:java
La page Angular (npm start dans iot-frontend-angular, puis
http://localhost:4200) affiche alors les messages avec leur partition et
leur offset, qui augmente à chaque ligne.
Voir le topic avec Kafdrop
kafka-console-consumer.sh est l’outil de base. Pour voir le topic dans
un navigateur, Kafdrop
est une interface web pour Kafka (licence Apache 2.0, Java 17 ou plus).
Il ne fait pas partie du projet : je le lance à côté, avec son jar
officiel (release 4.3.0), sans rien changer au projet :
java --add-opens=java.base/sun.nio.ch=ALL-UNNAMED \
  -jar kafdrop-4.3.0.jar --kafka.brokerConnect=localhost:9092
Puis http://localhost:9000, le topic iot-sensor-events, et ses
messages :
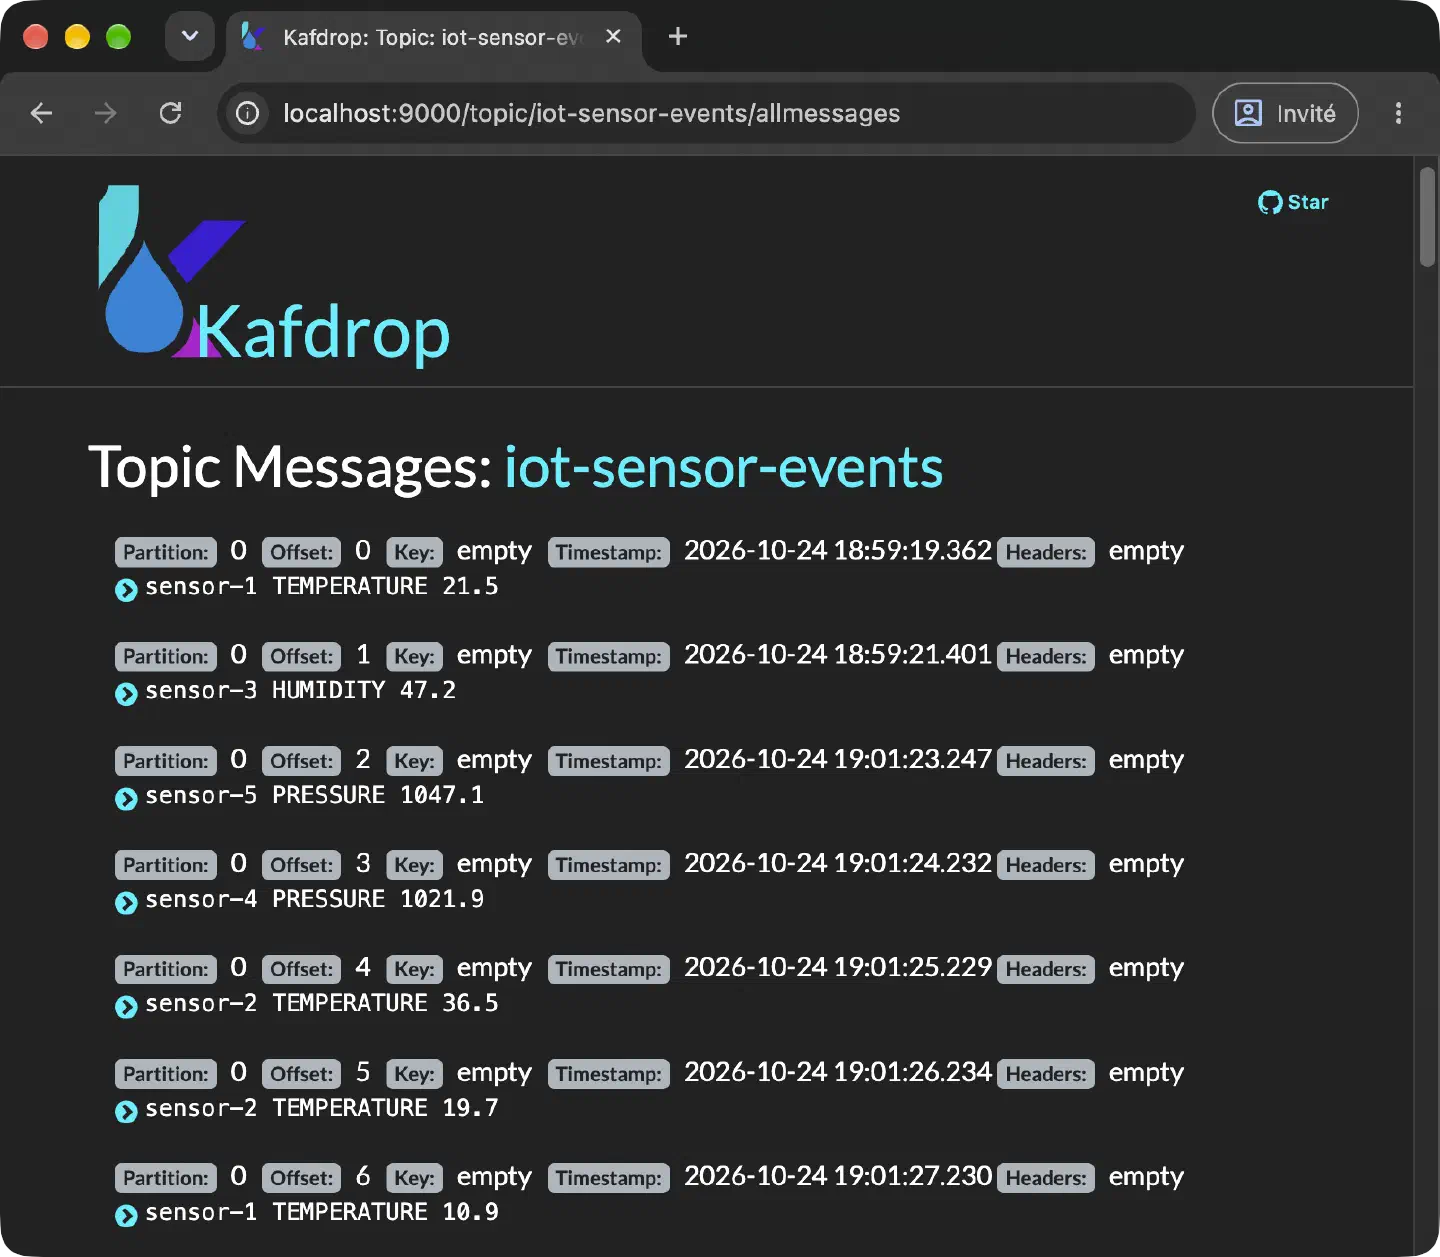
On retrouve tout ce qui précède : une seule partition, des offsets qui se
suivent, et Key: empty sur chaque message, puisque le service publie
sans clé.
Kafdrop tourne sur la machine et pas dans un conteneur, pour une raison
déjà vue : Kafka annonce localhost:9092. Depuis un autre conteneur,
cette adresse désigne le conteneur lui-même, et la connexion échoue.
Il faudrait un deuxième listener dans compose.yaml ; ce sera pour la
phase 2.
Ce qui manque, exprès
Ce projet est volontairement minimal. Il lui manque ce qu’un vrai système aurait :
- une clé de message : sans clé et avec une seule partition, l’ordre est gardé ; avec plusieurs partitions, il faudra une clé (le capteur) pour garder l’ordre des messages d’un même capteur ;
- plusieurs partitions et plusieurs consommateurs, pour traiter en parallèle ;
- la gestion des erreurs : aujourd’hui, un envoi raté ne laisse qu’une ligne de log, et un message qui ne peut pas être stocké est réessayé avec les réglages par défaut de Spring Kafka, puis perdu ;
- un événement typé avec un contrat, à la place d’une ligne de texte.
C’est le programme de la phase 2 du projet, avec ses propres articles.
Testé avec
Java 25 (Temurin 25.0.4), Spring Boot 4.1.2, Apache Kafka 4.4.0 (image
apache/kafka:4.4.0), PostgreSQL 18.6, Maven 3.10.0, Docker Desktop sur
macOS, Kafdrop 4.3.0. Code : tag
phase-1.
Sources
- Apache Kafka 4.0.0 Release Announcement (Kafka sans ZooKeeper, KRaft par défaut)
- Kafka : Getting Started, Docker
(l’image
apache/kafkaet sa configuration par défaut) - Kafka : configuration du consommateur,
auto.offset.reset - Spring Boot : Kafka
(le
KafkaTemplateauto-configuré, les beansNewTopic) - Spring for Apache Kafka : Sending Messages
(
sendrenvoie unCompletableFuture) - Spring for Apache Kafka : Configuring Topics
- Kafdrop (README, licence)
Pour aller plus loin
- Le README du tag
phase-1: tout le projet, la page Angular et son proxy de développement. - L’article suivant de la série : Architecture hexagonale avec Spring Boot : un exemple simple, l’organisation du code du service de processing.